Gemini Live 音频
文章目录
Gemini Live 音频
Gemini Live audio — simonwillison.net · 3 小时前 · 🤖 AI / ML
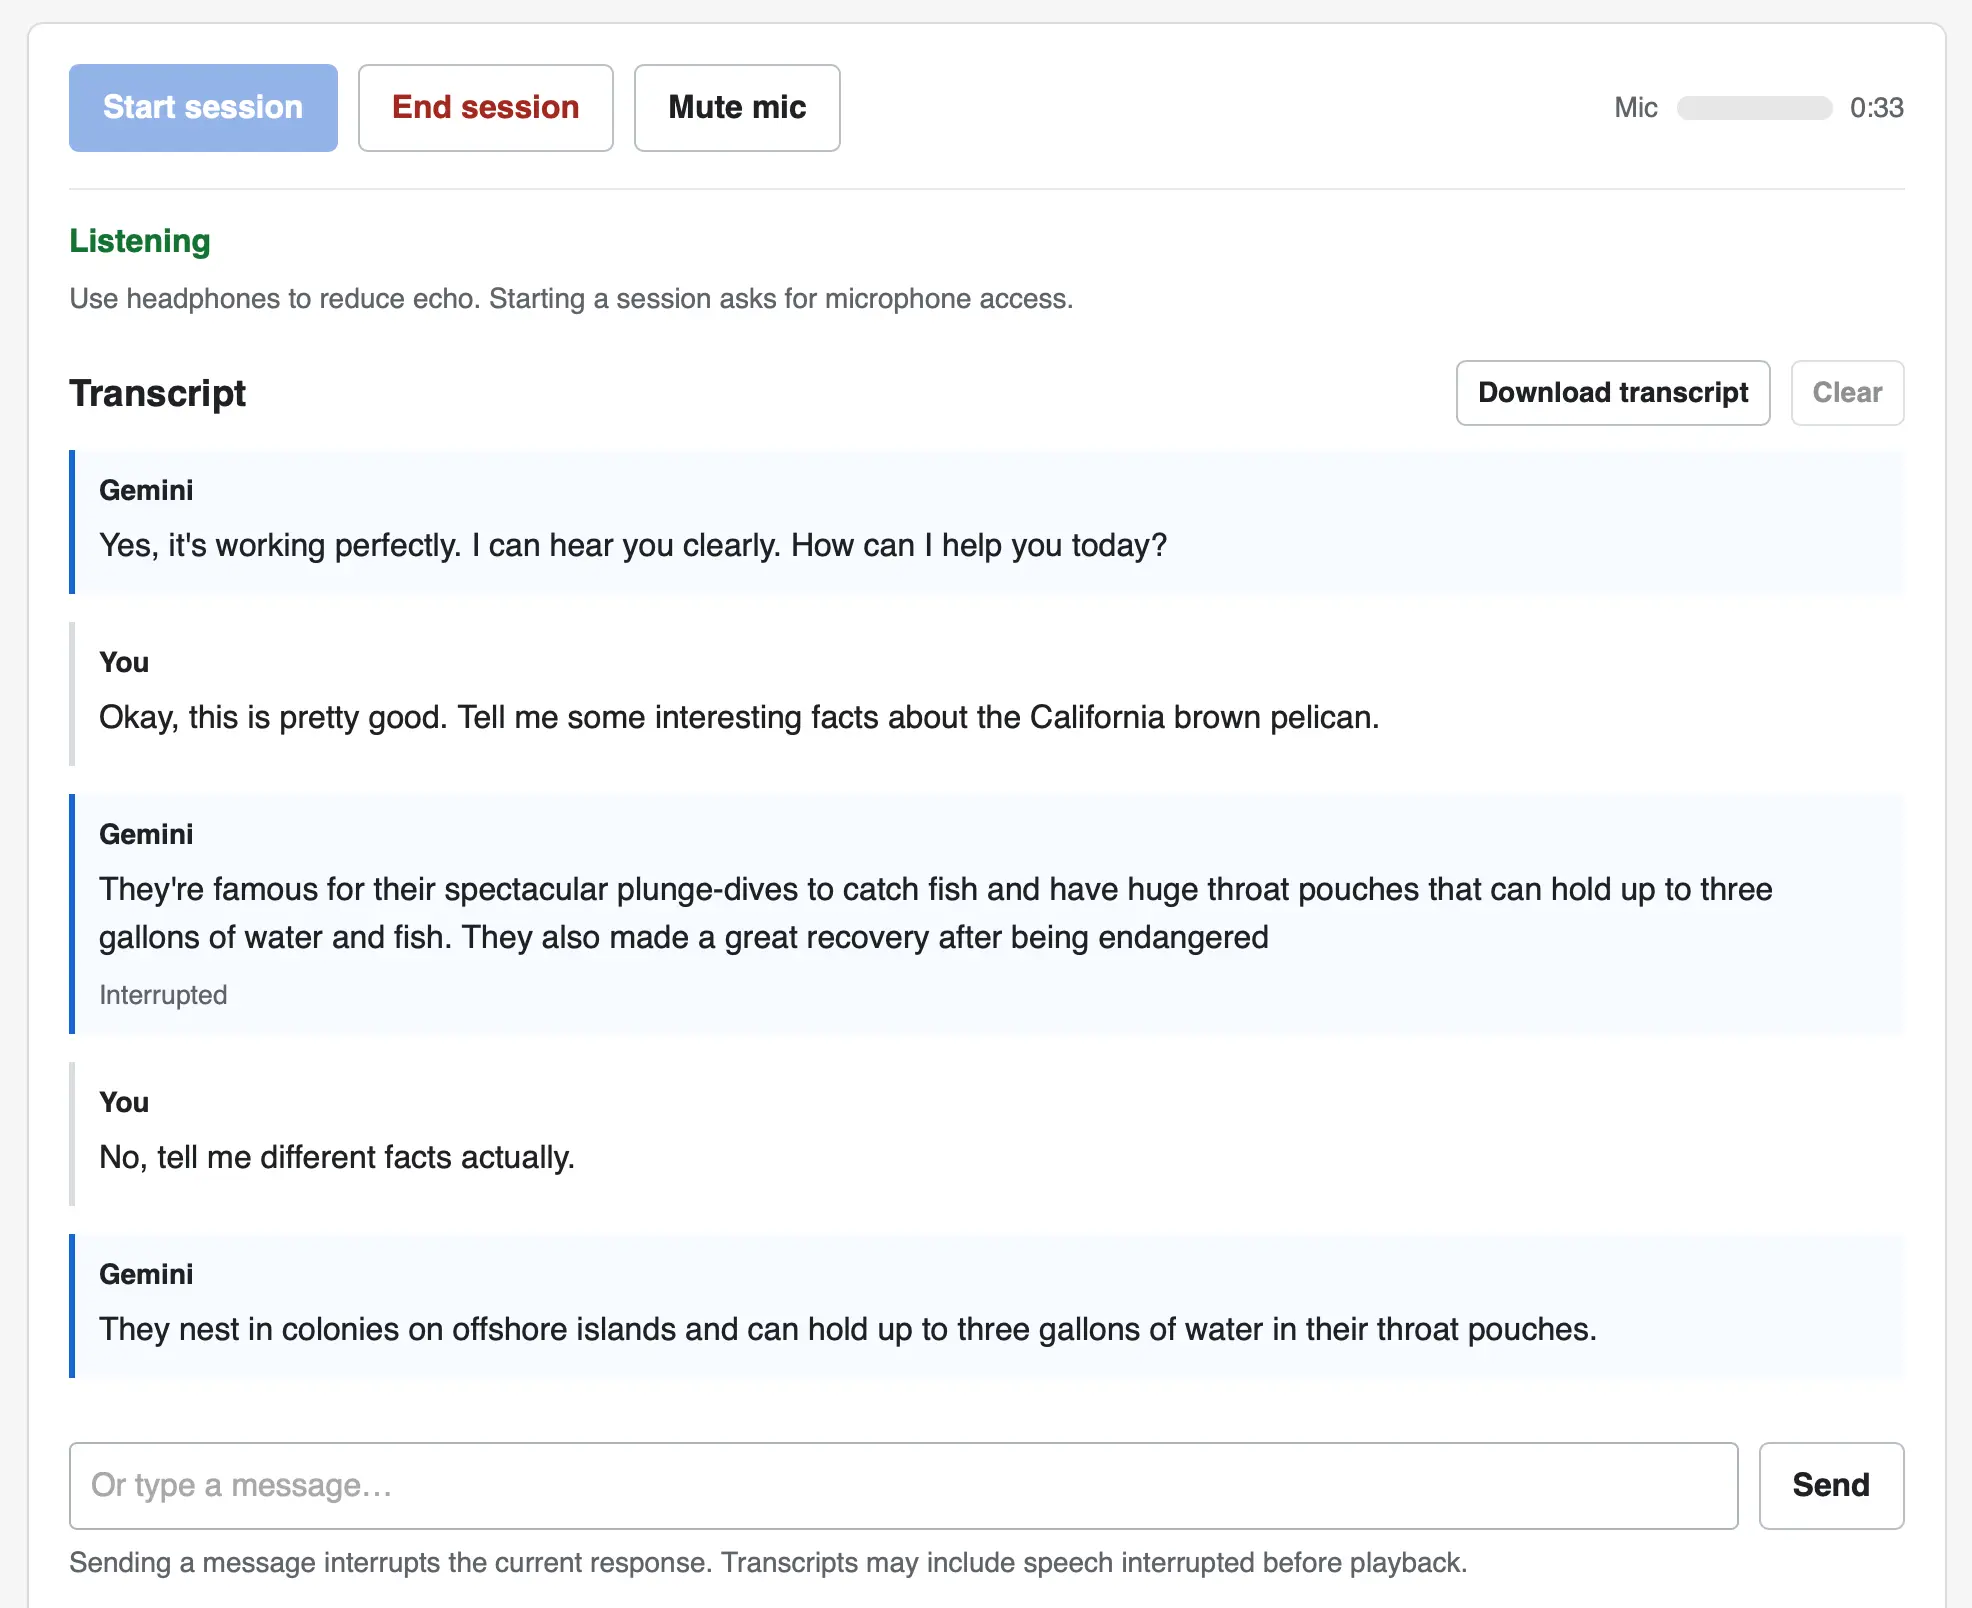
Google 在同一天发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两个语音到语音模型,产品形态与 OpenAI 的 GPT-Live 家族基本对齐,标志着实时语音对话这条赛道正从「语音识别 + 文本大模型 + 语音合成」的三段式拼接,转向端到端的原生语音模型。Simon Willison 没有手写代码,而是把官方文档直接喂给 GPT-6 Astra Extra High,让它生成一个可以在浏览器里试玩新模型的网页界面:先选模型,再挑音色预设,可选填一段系统提示词,随后就能直接开口对话;界面还支持在模型说话的过程中打断它,让模型立刻停下来听你说。这个看似微小的细节其实是实时语音体验的分水岭——传统级联管线在语音合成播放阶段是单向的,用户想插话往往要等模型把话说完,或者依赖额外的静音检测与打断逻辑,而端到端模型把「听」与「说」放进同一个会话状态,才可能做出自然的抢话与轮次切换。工程侧的门槛同样不低:浏览器要处理麦克风授权、回声消除、抖动缓冲、音频重采样,并通过 WebSocket 维持一条双向流式通道持续上传与下载音频;Extended Thinking 变体则在回答前投入更多推理时间以换取更高质量,代价是首字延迟明显上升,适合复杂任务而非闲聊。作者的核心观点是,模型发布只是起点,能否在几小时内做出一个可用的交互界面,才是开发者真正要跨过的坎,而让前沿模型阅读文档直接生成原型,正在把这件事的成本压到接近零。
核心论点
- Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 是 Google 同日发布的两款语音到语音模型,定位与 OpenAI 的 GPT-Live 系列同构,二者的差异在于后者会在开口回答之前进行更长时间的推理,用首字延迟换取复杂任务上的回答质量。
- 演示界面的功能边界很具体:模型下拉选择、音色预设选择、可选的系统提示词输入框,以及通过浏览器麦克风直接发起语音会话,其中最关键的交互能力是可以在模型说话时打断它,而不是只能等它说完再轮到自己。
- 整个 UI 不是手写的,而是把官方文档交给 GPT-6 Astra Extra High 生成的,这条工作流本身说明文档质量已经成为模型能力的一部分——只要接口文档足够清晰,前沿模型就能一次性产出可运行的流式音频前端。
- 打断能力背后是一组硬性工程约束:需要服务端语音活动检测判断用户何时开口、需要双向流式传输同时承载上行与下行音频、需要在用户插话时立刻取消正在生成的响应与正在播放的音频缓冲,任何一环缺失都会让对话退化成对讲机式的轮流发言。
💡 为什么值得读: 想动手接入实时语音模型的开发者可以把它当成一份最小可用的参考实现:既看清了两个新模型的定位差异,也看清了打断、流式传输这类真正决定语音体验的工程细节。
🏷️ Gemini, speech-to-speech, LLM, audio
留下一点回声