Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna,以及一场新的价格战
文章目录
Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna,以及一场新的价格战
Claude Opus 5.5, GPT-6 Sol, GPT-6 Luna, and a new price war — simonwillison.net · 23 小时前 · 🤖 AI / ML
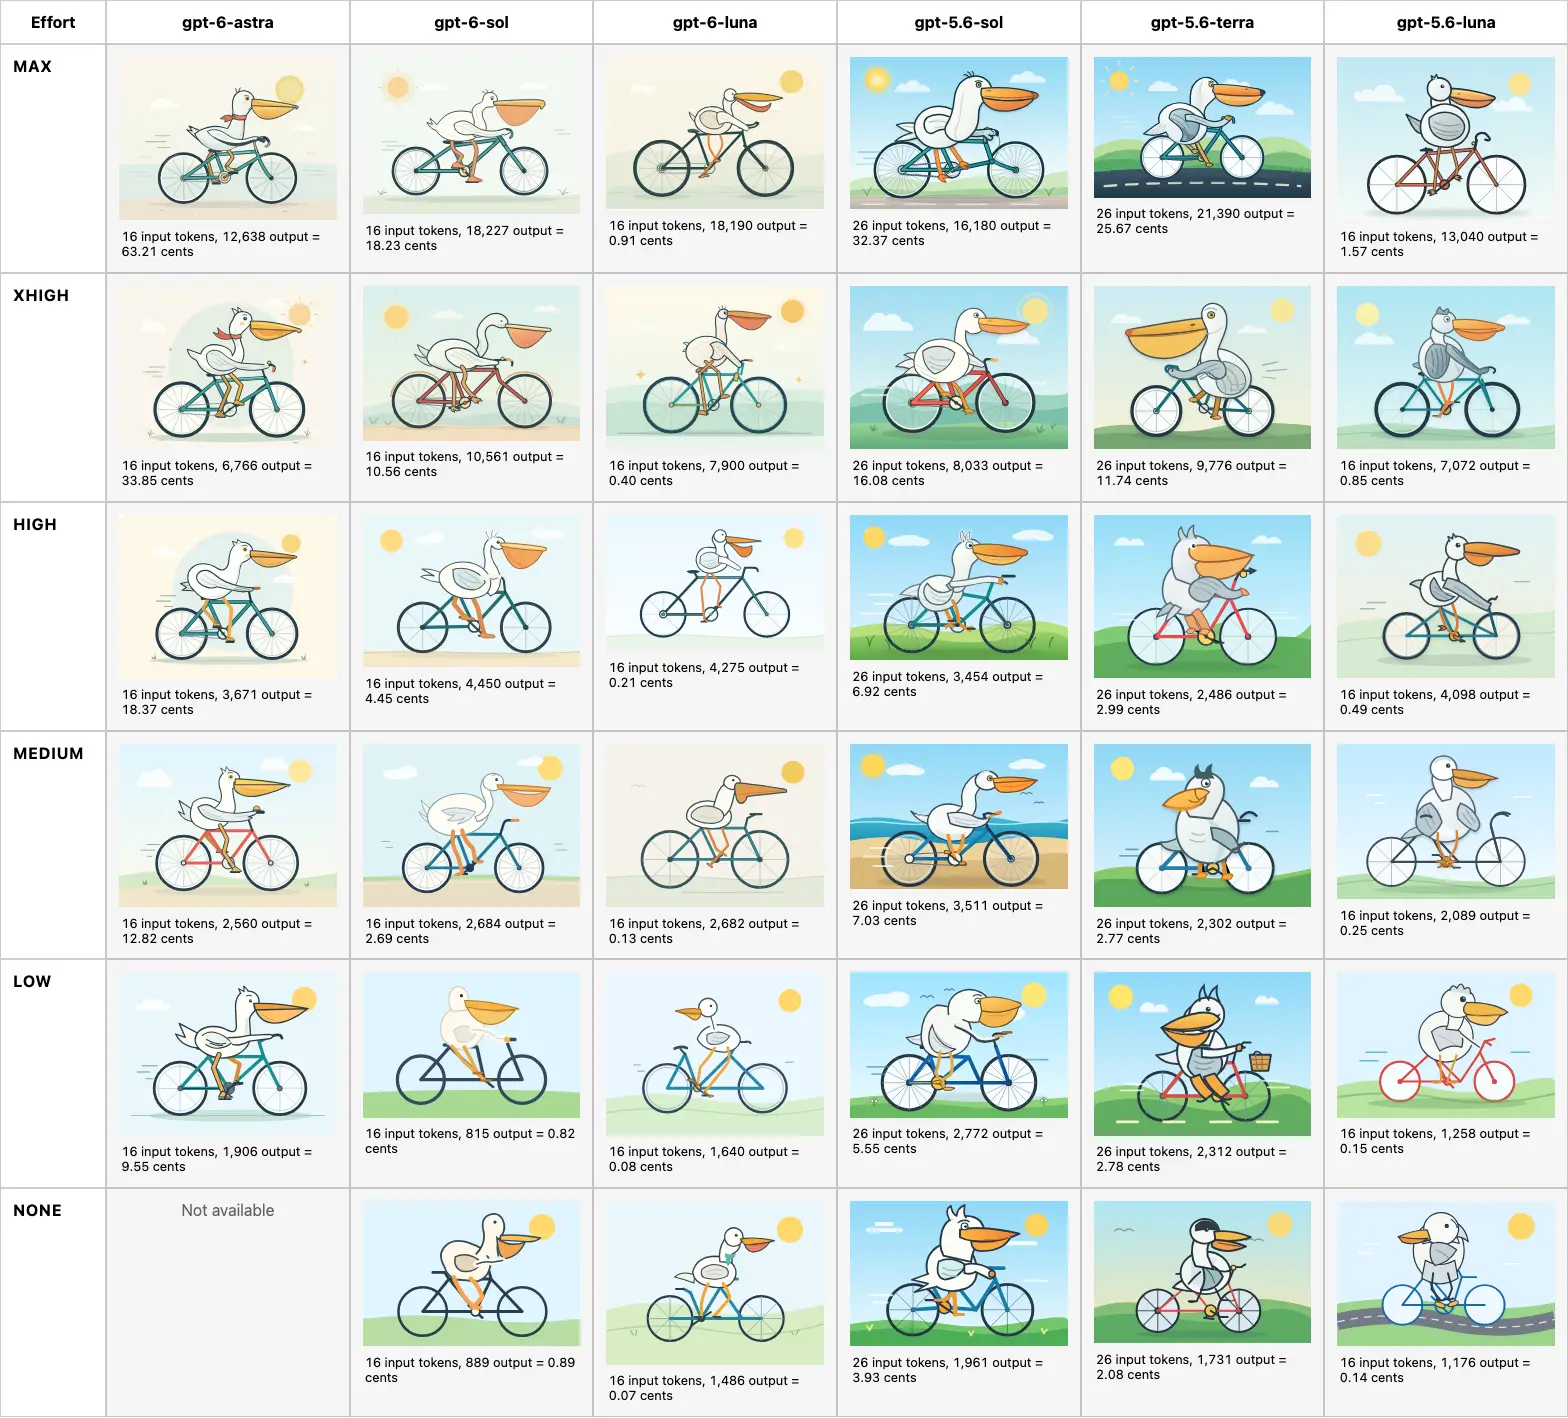
模型发布节奏已经密集到无法逐条消化的程度:昨天刚出现 Grok 4.7 和 MiMo v2.6 Flash/Pro,今天 Anthropic 发布 Claude Opus 5.5,大约一小时后 OpenAI 又端出 GPT-6 Sol 与 GPT-6 Luna,48 小时内五款新模型挤进同一条赛道,作者坦言要真正读懂它们还需要时间,以下只是第一时间的印象。最硬的信息是价格:GPT-6 Sol 和 GPT-6 Luna 的定价只有对应 GPT-5.6 档位的一半。作者此前已经把 GPT-5.6 Luna 当作自己构建应用时最顺手的模型,因为它在性能与成本之间取得了难得的平衡;价格腰斩意味着同样预算能跑出两倍的 token 吞吐,对长上下文、多轮工具调用的 agent 类应用来说,这是直接改写成本结构的变化,也让「默认选最贵旗舰」的惯性不再成立。与此同时,Anthropic 用 Claude Opus 5.5 守住高端推理定位,OpenAI 用 Sol 与 Luna 两个档位同时覆盖高性能与低价位,两家在同一天正面相遇,说明竞争焦点正从榜单分数转向单位成本下的可用性。作者评估新模型时依旧沿用他的标志性测试:让模型生成一幅骑自行车的鹈鹕 SVG,用它快速感受指令遵循、空间关系理解和代码生成质量,Grok 4.7 与 MiMo v2.6 的鹈鹕表现也被顺带提及。结论是:这一轮发布真正值得关注的不是某款模型是否登顶,而是价格战把高质量模型的边际成本压到了什么位置;在实测数据、延迟表现和稳定性样本积累起来之前,任何排名都只是临时结论,他更愿意用真实开发任务而非跑分来决定自己到底用哪个模型。
核心论点
- GPT-6 Sol 与 GPT-6 Luna 的定价只有同档 GPT-5.6 的一半,这是整轮发布中最具操作性的数字:作者此前把 GPT-5.6 Luna 当作构建应用的首选,因为它把不错的性能与低价格结合在一起,价格再砍一半之后,同等预算能换到两倍的 token 吞吐,长上下文、多轮工具调用和批量离线任务的经济性被彻底改写,很多原本必须上旗舰模型的场景可以下移到更便宜的档位,选型决策的重心也从跑分高低转向每百万 token 能买到多少可用质量。
- 48 小时内 Grok 4.7、MiMo v2.6 Flash/Pro、Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna 五款模型接连落地,其中 OpenAI 在 Anthropic 发布 Opus 5.5 之后大约一小时就放出新模型,时间差本身就是竞争信号;Anthropic 用 Opus 5.5 巩固高端推理与长任务定位,OpenAI 用 Sol 与 Luna 两个档位同时覆盖质量优先与成本优先两类需求,价格战从边缘小模型蔓延到主力型号,说明厂商已经默认单位成本而非榜单分数才是客户的真实决策依据。
- 作者评估这批新模型时继续沿用他的标志性测试——让模型生成一幅骑自行车的鹈鹕 SVG,这个任务能一次性暴露指令遵循、空间关系理解、代码结构与细节处理上的差异,Grok 4.7 和 MiMo v2.6 的鹈鹕也先经过这道关卡;他同时强调,模型发布当天的第一印象不足以支撑选型,需要等真实应用负载、延迟分布和长时间稳定性数据沉淀后再下判断,所以这篇文章给出的是方向性观察而非最终排名。
💡 为什么值得读: 因为它在同一天的窗口里横向对比了三家实验室的发布节奏,并给出一个能立刻用上的判断:价格减半对技术选型的影响,往往比榜单上几名之差更直接。
🏷️ Claude Opus, GPT-6, LLM, price war
留下一点回声