OpenAI 发布 GPT-6.1 Sol Ultrafast 版:最高 8 倍速度、价格为标准版 6 倍
文章目录
OpenAI 发布 GPT-6.1 Sol Ultrafast 版:最高 8 倍速度、价格为标准版 6 倍
OpenAI 推出 GPT-6.1 Sol Ultrafast 版:6 倍价格、最高 8 倍速度 — ithome.com · 2 小时前 · 🤖 AI / ML
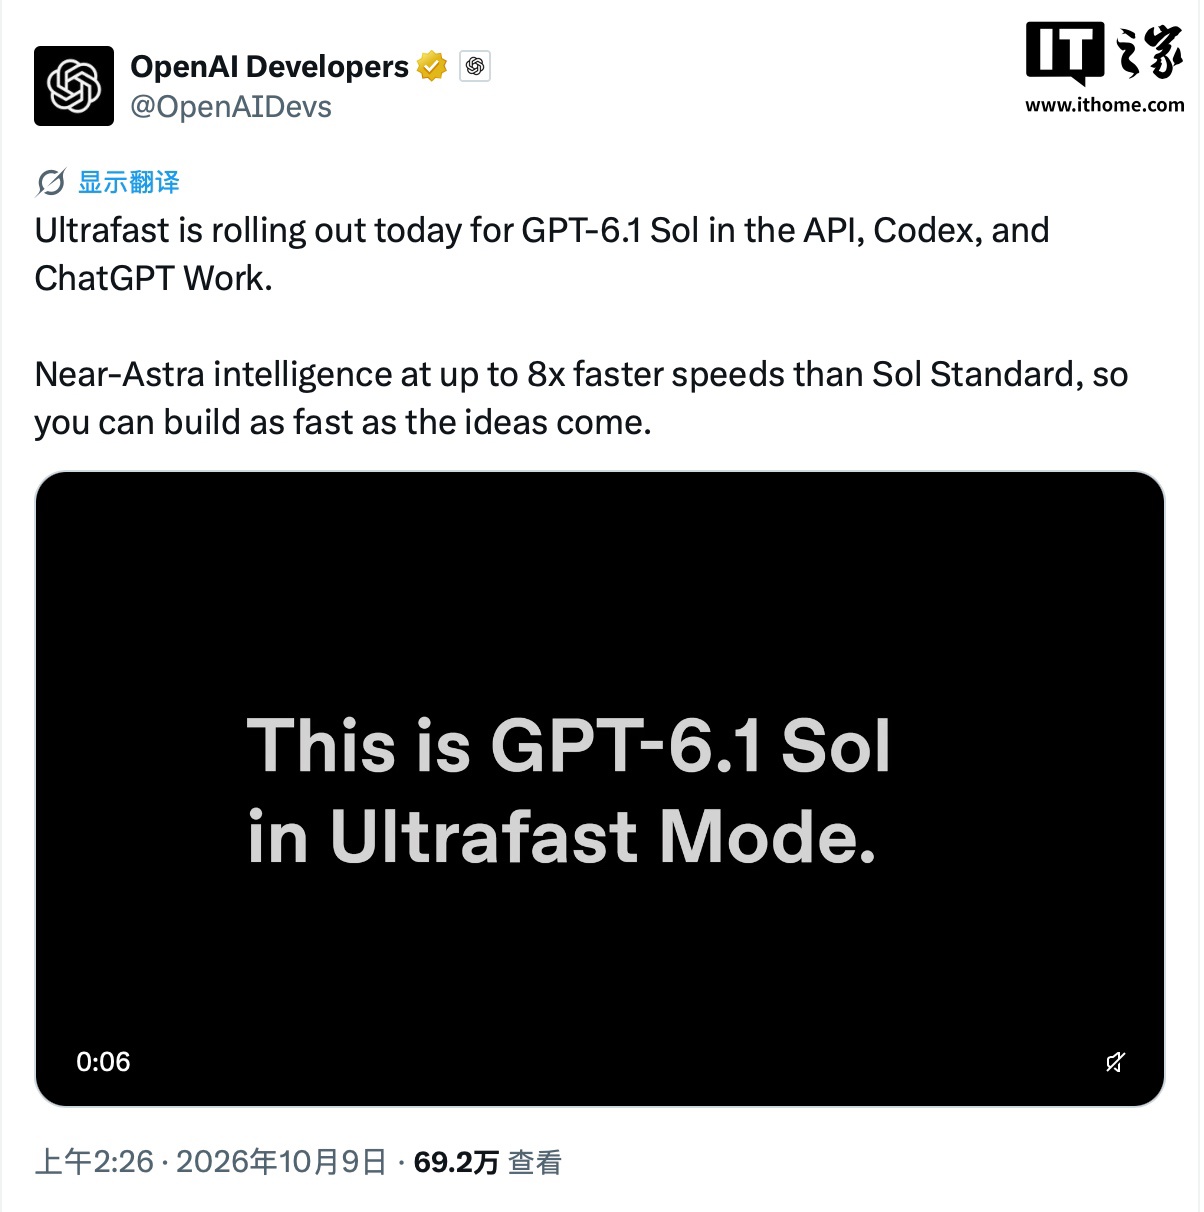
OpenAI 面向开发者与生产环境的高并发需求,推出 GPT-6.1 Sol 的 Ultrafast 版本,核心聚焦在更快响应与更高吞吐能力的成本权衡。根据官方披露,Ultrafast 的运行速度最高可达 Sol Standard(Sol 标准版)的 8 倍,而价格定为标准版的 6 倍:输入按每百万 tokens 12 美元计费,输出按每百万 tokens 60 美元计费(IT之家同时给出约合人民币 80.5 元与 402.7 元的换算)。在可用范围上,该功能已在 API、Codex 与 ChatGPT Work 中上线,并且在 Codex 与 ChatGPT Work 的适配中提供了分层开放策略:Pro 500 用户、符合条件的按量付费企业版(usage-based Enterprise)、以及采用配额计费的教育版(credit-based Edu)可直接使用;企业侧由于权限管理机制,仍需要由管理员主动开启。地域与合规要求方面,面向 GPT-6.1 Sol 的 Ultrafast 版已在所有支持区域上线,并全面支持美国与欧盟境内的数据驻留合规服务,减少了企业在跨境数据流转与审计方面的顾虑。整体来看,官方传递的结论是:在同一代模型框架下,通过特定的加速档位提供更高的速度上限,但以更高的单位计费作为代价,适合对延迟极敏感或对吞吐有更高要求的场景。对开发者来说,关键在于用更短的交互等待时间换取成本,并结合数据合规与权限流程完成部署决策。
核心信息
- 速度档位方面,GPT-6.1 Sol Ultrafast 被定义为相对 Sol Standard 的加速选项,其最高运行速度可达到标准版的 8 倍,面向需要低延迟与更快迭代的任务链路。
- 价格与算量的对应关系被明确为“标准版的 6 倍”:输入每百万 tokens 12 美元、输出每百万 tokens 60 美元,这意味着当任务输出更密集时,成本放大更明显,计费策略需要按工作负载评估。
- 在产品入口上,该能力覆盖 API、Codex 与 ChatGPT Work;其中 Codex/ChatGPT Work 的开放遵循分层:Pro 500、符合条件的按量付费企业版与配额计费教育版可用,但企业需要管理员主动启用权限,避免默认不可见导致的上线延迟。
- 合规与地域支持是上线条件的一部分:Ultrafast 已在所有支持区域可用,并“全面支持”美国与欧盟境内的数据驻留合规服务,使企业在选择更快档位时仍能维持数据治理要求。
💡 为什么值得读: 它把最高 8 倍的速度提升与可核算的 6 倍成本、以及区域数据驻留合规和权限开放机制一起给到开发者,因此更容易直接用于生产选型。
✍️ 小编看法: 从工程落地的角度看,Ultrafast 的价值不在“更快”三个字本身,而在它把速度与成本、合规与权限这些现实约束打包成了可选开关。过去很多团队想压延迟,往往只能用缓存、缩短上下文、切分任务或更激进的并发策略来对冲;但当有了明确的速度上限(最高到标准版的 8 倍)以及清晰的单价倍率(价格为标准版的 6 倍)时,工程决策可以从经验主义变成可量化的预算分配:要不要为“交互等待时间”付费,取决于业务指标,比如转化率、客服排队、研发编译/检索循环周期等。需要注意的是,速度提升带来的“隐藏成本”往往不只体现在 tokens 单价上,还体现在系统侧的节奏变化:响应变快后,队列与下游处理可能成为新的瓶颈,日志、重试、鉴权与审计链路也可能需要跟着降延迟,否则会出现局部加速但端到端体验不升反降的情况。企业治理也容易被忽略:企业需要管理员开启权限这一点意味着上线窗口可能被组织流程拉长,建议在试点阶段就把权限开关、区域合规与数据驻留配置纳入验收清单。对行业而言,这类“加速档位”会推动更多产品走向分级计费与按延迟敏感度路由,形成更精细的成本控制方法:高优先级请求用 Ultrafast,低优先级批处理走标准档。接下来值得关注的,是不同入口(API、Codex、ChatGPT Work)在同等输入输出下的实际端到端延迟差异,以及在美国与欧盟驻留合规模式下是否存在额外的性能波动,同时也要观察开发者社区对权限与配额策略的最佳实践沉淀是否会加速形成。
🏷️ GPT-6.1 Sol, Ultrafast, API pricing
本文由 AI 辅助生成,内容为原文摘要与编辑点评,原文版权归原作者所有,欢迎点击上方链接阅读完整内容。
留下一点回声